Robots.txt — текстовый файл в корне сайта с правилами обхода для поисковых роботов. Первая проверка занимает минуты: откройте https://ваш-домен/robots.txt с боевого адреса (с той схемой и зеркалом, которые в рекламе и сертификате) и убедитесь, что файл отдаётся как текст и не содержит полного запрета Disallow: / без осознанной причины.
Что делает файл и чего не делает
Робот при обходе запрашивает robots.txt и ориентируется на директивы. Типичное содержимое:
User-agent— к каким ботам применяются правила (*= ко всем);Disallow/Allow— какие пути не обходить или, напротив, разрешить внутри запрета;Sitemap:— указатель на карту сайта.
Это не юридический документ и не гарантия удаления из индекса. Закрыть обход ≠ гарантированно убрать URL из выдачи: для снятия из индекса обычно нужны noindex, инструменты вебмастера или естественное выпадение без повторного обхода.
Как открыть и что считать нормой
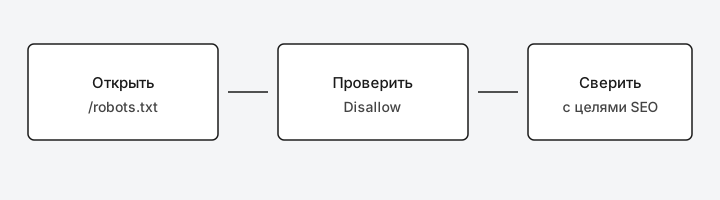
- Возьмите канонический адрес главной без UTM и хвостов.
- Добавьте
/robots.txt. - Откройте в браузере (лучше в режиме инкогнито).
Нормально: текст с директивами, HTTP-успех, без HTML-шаблона сайта. Настораживает: 404/403 при «файле в панели CMS», редирект на красивую заглушку, полный Disallow: / на проде.
Типичная конфигурация для публичного B2B-сайта — закрыты служебные зоны, корень открыт:
`` User-agent: * Disallow: /admin Disallow: /cart Disallow: /search ``
Конфигурация «сайт не для поиска» (нормально на стенде, опасно на проде):
`` User-agent: * Disallow: / ``
Как читать директивы без справочника
Трёх понятий достаточно для управленческой проверки.
User-agent задаёт адресата правила. Блок для * действует по умолчанию; отдельные блоки для Googlebot / Yandex могут отличаться — смотрите оба, если они есть.
Disallow запрещает обход пути. Пустой Disallow: обычно значит «запретов нет». Disallow: / запрещает почти всё от корня.
Allow уточняет исключение внутри более широкого запрета. Часто встречается в автогенерируемых шаблонах CMS — строку стоит трактовать вместе с соседним Disallow, а не изолированно.
Если маска неочевидна (Disallow: /*?), не гадайте: зафиксируйте строку и спросите у разработчика, цепляет ли она коммерческие URL.
Типовые ошибки на проде
Перенос со стенда. На демо индекс закрывают намеренно; на боевой домен выкатывают тот же robots.
Расхождение зеркал. Разный ответ на http/https или www/без www. Проверяйте то зеркало, которое считается основным.
Конфликт с sitemap. В карте перечислены URL раздела, который Disallow закрывает. Робот получает противоречивые сигналы.
Подмена noindex. Закрыли обход «чтобы не светить», страница уже была в индексе — из выдачи она сама не исчезнет гарантированно.
Галочка в конструкторе. Переключатель «скрыть из поиска» перезаписывает ручные правки файла.
Чек-лист проверки
- Боевой HTTPS-адрес отдаёт ожидаемый текст robots.
- Нет
Disallow: /без решения «сайт ещё закрыт». - Коммерческие разделы (услуги, каталог, статьи, контакты) не попали под широкую маску.
- Служебные пути (админка, корзина, внутренний поиск) закрыты осознанно.
- Строка
Sitemap:ведёт на открывающуюся карту. - После правки файл на проде совпадает с тем, что в CMS (повторное открытие в инкогнито).
Поиск перечитывает robots не мгновенно: сначала подтвердите публикацию на проде, затем ждите переобхода.
> Внешняя сверка без кабинетов вебмастера: Проверить сайт в поиске бесплатно
Когда привлекать специалиста
Сами закроете вопрос, если файл короткий и пути узнаваемы. Подключайте подрядчика, если:
- десятки пересекающихся правил и разные User-agent;
- мультидомен / мультиязык;
- после правки пропали разделы из поиска;
- в панели один текст, по URL — другой.
Формулировка задачи подрядчику: «На https://домен/robots.txt убрать полный Disallow корня; оставить запрет только на admin/cart/search; прислать актуальный текст файла».
Что сверить с командой за 15 минут
| Вопрос | Зачем |
|---|---|
| Какой URL канонический в рекламе и сертификате? | Проверяете тот же robots, что видит робот |
| Есть ли правило «сайт в разработке» в CMS? | Оно может перетирать ручной файл |
| Какие разделы сознательно не для поиска? | Чтобы не открыть служебное «заодно» |
| Указан ли sitemap и открывается ли он? | Связка правил обхода и карты |
| Меняли ли robots на зеркале www/без www? | Иначе правка не попадёт в прод |
После согласования зафиксируйте в тикете целевой текст файла или перечень разрешённых/запрещённых префиксов. Так приёмка сводится к сравнению двух текстов, а не к устным «вроде открыли».
Отдельно проверьте мобильный и десктопный доступ к тому же URL robots: ответ должен совпадать. Расхождение по CDN или A/B на служебных путях редко, но встречается на сложных конфигурациях.
Итог
Проверка robots.txt — быстрый фильтр перед разговорами про «плохое SEO»: открыли боевой файл, убедились, что сайт не закрыт целиком, запреты служебные и согласованы с sitemap. Дальше смотрят доступность страниц, карту сайта и индексируемость конкретных URL.
Повторная мягкая проверка снаружи: Проверить сайт в поиске бесплатно.